Descarga ChatLLaMA – Creador de Conversaciones de IA con GPU Gratuitas
Resumen y Características Principales
ChatLLaMA es una plataforma de modelado de conversaciones de IA de vanguardia y de código abierto que permite a desarrolladores, investigadores y aficionados crear asistentes de chat privados y de alto rendimiento que se ejecutan directamente en su hardware de GPU. Al aprovechar la técnica LoRA (Adaptación de Rango Bajo) y entrenarse con el conjunto de datos HH de Anthropic, la herramienta ofrece interacciones fluidas en estilo diálogo mientras mantiene tamaños de modelo prácticos para GPUs de gama de consumo. Tres variantes de modelo – 30 B, 13 B y 7 B de parámetros – ofrecen la flexibilidad para ajustar el rendimiento según la VRAM disponible, asegurando que incluso estaciones de trabajo modestas puedan experimentar con modelos de lenguaje de última generación.
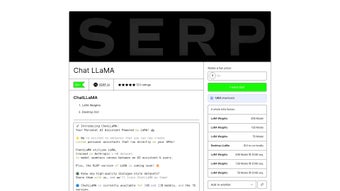
La interfaz gráfica de escritorio (GUI) simplifica la complejidad de los flujos de trabajo de línea de comandos, proporcionando un entorno visual para la selección de modelos, gestión de conjuntos de datos y pruebas en tiempo real de chat. Debido a que todo el procesamiento se realiza localmente, conserva el control total sobre sus datos, elimina la latencia causada por llamadas de API de ida y vuelta y evita costos recurrentes en la nube. Características impulsadas por la comunidad, como un portal de intercambio de conjuntos de datos y una distribución de pesos basada en Discord, enriquecen aún más el ecosistema, haciendo de ChatLLaMA una opción atractiva para cualquier persona que busque una solución de IA conversacional segura y personalizable.
- Tres tamaños escalables de modelo (30 B, 13 B, 7 B) para un rendimiento adaptable.
- La fine-tuning basada en LoRA permite una adaptación ligera sobre conjuntos de datos personalizados.
- Interfaz gráfica de escritorio intuitiva compatible con Windows, macOS y Linux.
- Aceleración nativa de GPU mediante CUDA para tiempos de respuesta inferiores a un segundo.
- Portal integrado de conjuntos de datos comunitarios para la mejora colaborativa de modelos.
- Licencia de código abierto Apache 2.0 con soporte opcional por Discord para acceso a pesos.
- Integración sin problemas con PyTorch y Transformers de Hugging Face.
- Procesamiento local seguro – ningún dato abandona su máquina a menos que active la telemetría.
Instalación, Configuración y Uso Diario
Configurar ChatLLaMA está diseñado para ser lo más sencillo posible, incluso para usuarios nuevos en el desarrollo de IA. Comience verificando que su sistema cumpla con los requisitos mínimos de GPU: una GPU NVIDIA con al menos 8 GB de VRAM y CUDA 11.6 o posterior. Visite la página oficial de lanzamientos en GitHub y descargue el instalador que coincida con su sistema operativo. El instalador incluye la GUI, un entorno Python mínimo y un runtime que detecta automáticamente su configuración de GPU.
Ejecute el instalador y siga la guía paso a paso: acepte el acuerdo de licencia, elija el directorio de instalación preferido (el predeterminado es C:\Program Files\ChatLLaMA en Windows, /opt/ChatLLaMA en Linux y /Applications/ChatLLaMA en macOS) y seleccione la variante de modelo con la que desea comenzar. El tamaño de descarga varía considerablemente – aproximadamente 15 GB para el modelo de 7 B y hasta 60 GB para el modelo de 30 B – por lo que se recomienda una conexión de banda ancha estable. Una vez que los archivos estén en su lugar, inicie la aplicación mediante el acceso directo de escritorio recién creado.
La primera ejecución presenta una guía de trabajo. Aquí puede importar un conjunto de datos personal de diálogo (formato CSV o JSONL) o navegar por el repositorio comunitario para encontrar fragmentos de conversación preseleccionados. Después de seleccionar un conjunto de datos, el panel "Selector de Modelo" le permite elegir el tamaño de modelo adecuado. Al hacer clic en "Cargar y Afinar", se inicia la adaptación LoRA, que se ejecuta en segundo plano en su GPU. La afinación suele completarse en minutos para el modelo de 7 B y en menos de una hora para el modelo de 30 B, dependiendo del tamaño del conjunto de datos y del hardware.
Una vez finalizada la afinación, cambie al panel "Consola de Chat". Aquí puede experimentar con comandos de lenguaje natural, ajustar parámetros de generación como temperatura, top-p y número máximo de tokens, y ver las respuestas de la IA en tiempo real. La consola también ofrece opciones de exportación para registros de conversación, permitiendo un análisis más profundo o integración con herramientas externas.
Si necesita ajustar los hiperparámetros LoRA, la pestaña "Ajustes Avanzados" proporciona un control granular sobre el rango, la tasa de aprendizaje y la regularización. Durante todo el flujo de trabajo, ChatLLaMA ofrece notificaciones de estado en tiempo real, registros de errores y un enlace de un solo clic al canal de ayuda en Discord. El actualizador integrado verifica nuevas versiones diariamente, asegurando que siempre tenga las últimas actualizaciones de seguridad y mejoras de modelo.
Compatibilidad, Requisitos del Sistema y Ventajas y Desventajas Detalladas
Plataformas Soportadas: Windows 10/11 (64 bits), macOS 11+ (Intel y Apple Silicon a través de Rosetta 2) y distribuciones principales de Linux como Ubuntu 20.04+, Fedora 33+ y Arch Linux. La aplicación depende de CUDA para la aceleración de GPU, por lo que cualquier sistema con una GPU NVIDIA compatible con CUDA 11.6 o posterior funcionará de forma inmediata. Los usuarios de macOS sin hardware NVIDIA pueden ejecutar el modelo de 7 B en modo emulación de CPU, pero el rendimiento será limitado y no se recomienda para cargas de trabajo de producción.
Ventajas
- Ejecución local en GPU proporciona latencia inferior a un segundo y elimina la dependencia de APIs externas.
- Varios tamaños de modelo permiten escalar desde portátiles modestos hasta estaciones de trabajo de alto rendimiento.
- La afinación LoRA hace que la integración de conjuntos de datos personalizados sea ligera y rápida.
- La interfaz gráfica elimina la necesidad de comandos complejos en línea de comandos.
- Licencia de código abierto Apache 2.0 que permite uso personal y comercial.
- Procesamiento seguro y centrado en la privacidad – los datos nunca abandonan la máquina local a menos que active la telemetría opcional.
- Comunidad activa en Discord que ofrece soporte rápido, distribución de pesos y intercambio de conjuntos de datos.
- Actualizador automático asegura que esté al día con parches de seguridad y mejoras de funciones.
Desventajas
- Requiere una GPU NVIDIA moderna; el uso exclusivamente en CPU es posible pero imprácticamente lento.
- Los pesos del modelo base no se incluyen con el instalador y deben obtenerse mediante registro en Discord.
- Grandes tamaños iniciales de descarga, especialmente para la variante de 30 B, pueden sobrecargar conexiones con ancho de banda limitado.
- La documentación, aunque mejora, puede ser escasa para la sintonización avanzada de hiperparámetros LoRA.
- Soporte nativo limitado para dispositivos Windows ARM y soluciones de gráficos integrados.
Preguntas Frecuentes
¿Necesito conexión a internet después de instalar ChatLLaMA?
No. Una vez instalados los archivos del modelo y la GUI, todo el proceso de inferencia se realiza localmente en su GPU. Una conexión a internet solo es necesaria para la descarga inicial del modelo o cuando elija obtener nuevos conjuntos de datos comunitarios.
¿Puede ChatLLaMA funcionar en una laptop sin GPU dedicada?
ChatLLaMA está optimizado para GPUs NVIDIA. Aunque el modelo de 7 B puede ejecutarse técnicamente en hardware exclusivamente de CPU, los tiempos de respuesta se vuelven prohibitivamente lentos, haciendo la experiencia inadecuada para chats interactivos.
¿Cómo obtengo los pesos del modelo base?
Los pesos base se distribuyen a través del servidor oficial de Discord. Después de unirse, envíe una breve descripción de su proyecto, y los moderadores comunitarios le proporcionarán un enlace de descarga seguro.
¿Alguna de mis conversaciones se envía a servidores externos?
Todo el procesamiento se realiza localmente. ChatLLaMA no transmite preguntas ni respuestas a menos que active explícitamente la telemetría en el panel de configuración.
¿Qué términos de licencia rigen a ChatLLaMA?
ChatLLaMA se lanza bajo la licencia Apache 2.0, permitiendo uso gratuito personal y comercial. Los adaptadores LoRA que cree son propiedad intelectual suya y pueden distribuirse según considere conveniente.
¿Puedo integrar ChatLLaMA con proyectos Python existentes?
Sí. La instalación incluye un entorno Python ligero con PyTorch y Transformers de Hugging Face. Puede importar el módulo de API proporcionado para llamar directamente al modelo desde sus propios scripts.
Conclusión – Descarga ChatLLaMA Hoy
ChatLLaMA combina el rendimiento local con GPU, la adaptabilidad LoRA y una GUI amigable en un solo paquete que destaca en el mercado saturado de asistentes de IA. Su naturaleza de código abierto y su activa comunidad en Discord la convierten en una opción confiable para desarrolladores que valoran la privacidad, la velocidad y la extensibilidad.
Si está listo para crear un chatbot de IA seguro y de alto rendimiento sin los costos recurrentes de APIs en la nube, ChatLLaMA es la solución que ha estado esperando. Haga clic en el enlace de abajo para descargar el instalador gratuito, siga la guía de configuración sencilla y comience a crear sus propios agentes conversacionales hoy mismo.